Big talk о некоторых аспектах автоматизированной генерации документов. В ролях: LaTeX, Metapost, GNU Emacs, Make, m4, bash :-) Здесь не написано о том, как пользоваться Латехом, Метапостом, Емаксом, как писать мейкфалы, сценарии командной оболочки и не рассказано о хитростях макропроцессора m4. Текст длинный и справочно-унылый, читать долго.
Конкретно, описано следующее:
-
как вставлять (удобно) куски исходников в LaTeX-документ
-
как (автоматически) внедрять (с удобством) результаты численных расчётов в документ
-
как организовать простую визуализацию данных с включением графиков в документ
Prelude: документирование кода
Хорошая документация неотделима от программы. Исходный текст на каком-то языке программирования и документация к нему должны быть представлениями одной сущности, разным способом выражая одно и то же — какой-то вычислительный процесс. Прозрачно связывать постановку задачи с чтивом для людей и внедрять в документ результат работы программы — тоже важно.
Генераторы справочников
Популярным решением для связывания исходного кода и документации являются утилиты типа Doxygen (C, С++, Java, PHP и т. д.), gtk-doc (используется в проекте Gtk+), SchemeDoc (аналогичное Doxygen решение для Scheme), Texinfo и десятки других. Их сущность — в написании специально оформленных комментариев в исходном коде, которые впоследствии обрабатываются программой-документером, в результате чего получается хорошо оформленная справочная документация по программному интерфейсу (см. к примеру доки по PyGTK). Такая документация неизменно носит оттенок механоидности (хотя это не всегда минус), но очень удобна в генерации и использовании. Doxygen, кстати, ещё может при помощи Graphviz рисовать графы зависимостей между структурами кода.
«Ъ™ программирование»
Более высокий уровень — «Literate Programming» («грамотное программирование» («глупый» перевод «литературное» тоже неплохо отражает сущность)): ведущим принципом в написании исходного кода программы является его читабельность и понятность человеку, документация и компилируемый код генерируются из высокоуровневого описания — это путь, который используют различные отпрыски WEB (сегодня, в частности, на Web2C написан TeX, Metafont). Подход не только грандиозно увеличивает понимаемость и читабельность программы, но и переносит сам процесс программирования на более высокий уровень, заодно делая его ещё более осмысленным.
Курсовая работа
В этом семестре я выполнил небольшую курсовую работу по дифференциальным
уравнениям. В качестве языка реализации — Scheme. Результатом программы
является приближённое решение u(x) уравнения d²u/dx² + n(x)u(x) = 0
(представленное в виде набора точек графиков действительной и мнимой
части u(x)) и ещё два коэффициента, которые нужно по задаче найти. К
реализации предлагается два метода решения задачи (описать надо оба,
заодно проверив друг другом результат каждого из них).
Оформить всё я решил при помощи LaTeX.
Требования
-
Результат работы нужно (графики
u(x)и два числа) представить в отчете по курсовой. -
Сорцы программы нужно включить в курсач (на бумаге) (тупость, но так надо; у меня не очень большой исходник получился)
-
Исходные данные (определение заданной по условию функции
n(x)на Лиспе и ещё некоторые числа) я просто записывал в отдельный файл «постановки задачи». Он используется при вычислениях, и из него же можно извлечь исходные данные и включить их в бумажный отчёт. Тогда можно будет просто поменять постановку задачи (один файлик), набратьmake docи получить отчёт по курсовой работе для новых исходных данных без каких-либо дополнительных действий руками. Итак, ещё одна нужность — выдернуть из постановки задачи нужные чиселки и включить их в LaTeX-документ. -
Для развёрнутого комментирования работы программы мне так же понадобилась возможность простого включения в LaTeX определения произвольной функции из произвольного файла в моём проектике.
Основным принципом является связывание бумажного отчёта и исходного кода программы (а так же её исходных данных и результатов) так, чтобы любое изменение программы немедленно и корректно отражалось в документации. В целом для обеспечения обновления определённых частей бумажного отчёта при изменении соответствующих аспектов программного кода использовалась сборочная система GNU make.
Файлы проекта полностью доступны в моём Mercurial-репозитории.
Доступен и скомпилированный мной PDF с курсачом.
Texdepend
Texdepend — небольшая утилита на Perl, являющаяся аналогом
makedepend для TeX-исходников. Как makedepend(1) распознаёт в
исходниках на Си директивы #include, так texdepend(1) рекурсивно
обрабатывает конструкции \input{}, \include{}, \usepackage{},
\includegraphics{} и другие. Из всех обрабатываемых texdepend
конструкций мне потребовались две — \input{} и \includegraphics{}.
В целом
Общий подход, который был применён для выполнения вышеобозначенных
требований — в исходнике на LaTeX пишется конструкция \input{} с
аргументом определённого вида, на исходник кастуется вызывается
texdepend, который выводит список «зависимостей». Полученные зависимости
формируются согласно своему типу, после чего движок TeX просто включает
сформированные файлы в документ.
Для управления процессом был написан Makefile + несколько простых и коротких скриптов на bash для генерации зависимостей.
В самом начале моего Makefile я написал:
include ${DOCNAME}-deps.mk
А в списке возможных целей описал правило сборки:
${DOCNAME}-deps.mk: ${DOCNAME}.tex texdepend -o $@ -print=if $<
Команда texdepend -o $@ -print=if $< генерирует списки зависимостей
для файла ${DOCNAME.tex}, рассовывая их по переменным ${INCLUDES},
${FIGS} и т. п. Включая при помощи include сгенированный файл в свой
Makefile я получаю возможность указать эти переменные в зависимостях
PDF-ки с курсачом:
${DOCNAME}.aux: ${INCLUDES} ${FIGS} ${DOCNAME}.tex ${DOCNAME}.bib pdflatex ${DOCNAME} bibtex8 -B ${DOCNAME}
${DOCNAME}.pdf: report.aux pdflatex ${DOCNAME} pdflatex ${DOCNAME}
doc: ${DOCNAME}.pdf
Итак, когда Make получает задание обновить цель doc, по зависимостям
обновляется report.aux, а следовательно и списки зависимостей из
${INCLUDES}.
Остаток Makefile составляют, собственно, правила для сборки зависимостей. О них и пойдёт речь.
Кроме того, другим обобщением здесь является сходность всех правил сборки этих зависимостей: сценарии shell подготавливают данные для включения и при помощи макропроцессора m4 подставляют их в шаблоны. Полученное и внедряется в LaTeX-документ!
Детали по порядку
Включение исходных файлов целиком
Конкретизирую задачу. Допустим, я хочу, чтобы, написав в нужном мне месте моего документа конструкцию
\input{matrices.scm-full-listing}
получить в этом самом месте красиво оформленный полный листинг файла
matrices.scm из моего проекта. Кроме того, я хочу уметь ссылаться на
этот листинг из других мест моего документа при помощи
\pageref{matrices.scm-full-listing}.
Listings: оформление кода в LaTeX
listings — замечательный пакет для LaTeX, дающих кучу возможностей
по оформлению включаемых в документ исходников. Умеет подсвечивать
синтаксис или выбранные лексемы в сорце, рисовать разные гламурные
рамки, добавлять индексные ссылки в листинг и многое другое. Для
включения исходника целиком я использовал определяемое этим пакетом
окружение lstlisting:
\begin{lstlisting}[label={__BASENAME-full-listing},title={Содержимое файла \filename{__BASENAME}}] __SOURCE \end{lstlisting}
Параметр label создаёт в месте этого листинг метку, на которую потом
можно будет ссылаться при помощи \pageref{__BASENAME-full-listing}.
Происхождение строчек __BASENAME и __SOURCE пока неясно, хотя смысл
их должен быть очевиден — это имя включаемого файла и его содержимое.
Механизм подмены этих имён реальными значениями рассмотрен далее.
Включаем!
Конструкция \input{matrices.scm-full-listing} посредством texdepend
породит на уровне make необходимость обновления цели
matrices.scm-full-listing.tex; для таких целей в моём Makefile
прописано такое правило с действием по маске («Pattern rule») такого
вида:
%-full-listing.tex: ${SOURCEDIR}/%
source-full-listing.sh source-full-listing.tpl.tex
$(SHELL) source-full-listing.sh $< > $@
Единственная команда в списке правил обновления цели вызывает простой
шелл-скрипт source-full-listing.sh с аргументом, равным полному имени
включаемого файла. Сам скрипт выглядит так:
SOURCE=$(cat $1 | grep -v "[ ];; ." | sed -e "s/^([ ]*);;@ /\1;; /")
BASENAME=$(basename $1)
m4 --define="__SOURCE"="${SOURCE}"
--define="__BASENAME"="${BASENAME}"
source-full-listing.tpl.tex
Его действие понятно: при помощи m4(1) он определяет два макроса
__SOURCE и __BASENAME, и выполняет замену их вхождений в файле
source-full-listing.tpl.tex на содержание исходника и его имя,
соответственно. Содержимое source-full-listing.tpl.tex — как раз
вышеприведённый фрагмент с \begin{lstlisting} .. \end{lstlisting}.
Видно, что решения этой задачи почти нет — он состоит из пяти простых
строчек. На самом деле, самое главное — в этой строке из
source-full-listing.sh:
SOURCE=$(cat $1 | grep -v "[ ];; ." | sed -e "s/^([ ]*);;@ /\1;; /")
По странному стечению обстоятельств, я пишу комментарии к коду на английском, что, вероятно, может некоторым образом смутить
преподавателя. Простейшим из универсальных языков является язык
математики, поэтому я применил такое правило: обычные комментарии
пишутся с ;;, а особые «математические» — с ;;@.
Математический комментарий оформляется напрямую теховским окружением
$ .. $. При работе по включению сорца в TeX, обычные комментарии тупо
вырезаются, а математические — оставляются. При этом в преамбуле
документа указана команда \lstset{mathescape=true}, заставляющая
пакет listings полностью обрабатывать (а не просто «дословно»
включать) выделенные при помощи $ .. $ части кода. Например, при
включении исходника со следующим текстом:
;; Check whether found a, b coefficients meet the conservation of ;; energy law: ;;@ $|A|^2 + |B|^2 = 1$ (define (energy-conserves? A B eps) (< (abs (- 1 (+ (expt (magnitude A) 2) (expt (magnitude B) 2)))) eps))
Комментарии с ;; просто удалятся, а формула |A|²+|B|²=1 корректно
заверстается в математическое окружение.
На самом деле, использование математических выражений для документирования определённого набора функций очень удобно — математическая нотация кратка и универсальна.
Извлечение отдельных участков кода
Для работы я решил развёрнуто прокомментировать основные вычислительные процессы, происходящие при построении решения. После краткого математического описания метода решения следует краткое описание процедур, относящихся к реализации метода, с отсылками к математическому описанию, перемежаемое собственно определениями этих процедур. То есть показывается связь кода программы и задачи. Хотелось иметь возможность написать по ходу текста что-то типа
\input{general-horner-eval__shared.scm-tag-listing}
И получить в этом месте содержимое функции general-horner-eval из
файла shared.scm (в дальнейшем описании для примера я буду
использовать именно эту функцию из этого файла)
Texdepend обработает эту конструкцию, потребовав от сборочной системы
обновления зависимости
general-horner-eval__shared.scm-tag-listing.tex. В правиле сборки
можно указать соответствующих файл с исходником (shared.scm) в
качестве зависимости — тогда листинг будет обновляться при изменениях в
коде. Оформлять листинги можно при помощи уже названного listings.
Остаётся одно — как-то вытащить из определённого файла тело определённой функции. Дальнейшие манипуляции с ним и оформление — дел нехитрой техники.
Сначала я посмотрел на Scheme Elucidator — ещё одно решение для документирования кода на Scheme: в отличие от того же SchemeDoc, Elucidator не просто генерит доки по интерфейсу, а плотно связывает особенности вычислительного процесса с документацией. Изначально я собирался использовать это решение для курсача, однако отказался по нескольким причинам (пришлось бы перелопачивать вывод Elucidator (это HTML) в TeX; LAML, на котором Elucidator основан, не совсем удобен и негибок в установке; лишние значительные зависимости; исходная задача слишком простая для Elucidator).
Однако потом я вдруг вспомнил, что работаю в Emacs, где есть Semantic, так что написал коротенькую программку на Emacs Lisp с использованием Семантика, которая просто выводит на стандартный вывод содержимое заданного тега в заданном файле. Использование Semantic для этой задачи раскрывается в другой моей записи, сейчас будем считать, что команда
$ emacs --batch --load grok-lisp.el
--exec '(print-tag-from-file "general-horner-eval" "shared.scm")'
2> /dev/null
подаёт на стандартный вывод содержимое функции general-horner-eval в
файле shared.scm.
Я уже условился называть файлы, содержащие тела процедур для включения,
по схеме function__file-tag-listing.tex, так что получается вот такое
правило в Makefile:
%-tag-listing.tex: ${SOURCEDIR}/$$(call get-target-source,$$)
tag-listing.sh tag-listing.tpl.tex grok-lisp.el
$(SHELL) tag-listing.sh $(shell echo $ | sed -e "s/__.*//") $< > $@
Первая зависимость в этой хитроумной комбинации вычленяет из имени цели
general-horner-eval__shared.scm-tag-listing.tex часть shared.scm
(имя исходника, откуда берётся функция — для обновления листинга при
изменении сорца). Функция get-target-source задаётся в Makefile выше
по тексту таким образом:
define get-target-source $(shell echo $1 | sed -e "s/.*__//") endef
Остальные зависимости заставляют обновлять цель при изменении самих механизмов обновления, а собственно правило сборки вызывает команду
tag-listing.sh general-horner-eval shared.scm
В свою очередь, tag-listing.sh при помощи Emacs извлекает
определение нужной функции из файла и подставляет его (при помощи
m4(1)) вместо строки __SOURCE в файл-шаблон tag-listing.tpl.tex,
общий для всех листингов и имеющий такое содержание:
\begin{lstlisting}[frame=tbrl,frameround=tttt,aboveskip=0.5cm, belowskip=0.5cm] __SOURCE \end{lstlisting}
Он сходен с уже рассмотренным ранее шаблоном для включения сорца целиком и тоже использует пакет listings.
Ввиду указанного в Makefile перенаправления > $@ в конце вызова
tag-listing.sh, извлечённая из исходника и обрамлённая в конструкции
LaTeX функция попадает в
general-horner-eval__shared.scm-tag-listing.tex, который и включается
в документ.
В итоге, вся цепочка вызовов порождается лишь самим существованием команды
\input{general-horner-eval__shared.scm-tag-listing.tex}
в TeX-исходнике.
Нельзя сказать, что применение Elisp здесь обязательно — того же эффекта
получения кода произвольной функции можно добиться и при помощи утилиты
etags(1) + тех же grep(1), head(1) и sed(1); однако
выразительность такого решения была бы меньше. Кроме того, код на Elisp
очень быстро пишется и быстро отлаживается.
Lisp2TeX
После решения задачи на Elisp я обнаружил Lisp2TeX — похожее решение
ровно для таких же целей — включать определённые части кода на Scheme в
TeX при помощи удобных конструкций. L2T очень гибок и позволяет не
просто включать сырец в TeX, но и делать pretty-print листинга (красиво
расставлять отступы), и включать результаты вычисления произвольных
S-выражений в него, и даже визуализировать S-выражения при помощи
pic — это просто замечательный уровень работы. Кроме того, L2T умеет
приводить включённые выражения Лиспа в ещё более читабельный формат
(превращать (f x y) в \varphi(x, y) и гораздо более сложные
выражения гибко преобразовывать по шаблонам).
Без сомнения, Lisp2TeX в связке с оформлением из уже упомянутого
LaTeX-пакета listings даёт гораздо более качественное решение, нежели
описанные выше костыли на основе Emacs+Semantic и обёрток на shell.
Lisp2TeX имеет возможность привязки к себе любых парсеров, что делает
его пригодным к использованию с сорцами на любых языках, а не только
всяких Лиспах.
Впрочем, я в итоге не стал сейчас юзать L2T. Имелись проблемы с компиляцией Lisp2TeX (плюс он подвязан на определённые реализации Scheme), и мне нравилось использовать texdepend для получения списка нужных для сборки курсача файлов данных, а так пришлось бы юзать и Lisp2Tex, и texdepend.
Буду писать большой серьёзный папир, обязательно применю Lisp2TeX, а сейчас он показался мне лишним — да и в решении через Elisp основные сложности лишь в написании правила для Makefile (остальные скрипты там по две строки максимум). Да, мне стыдно и у меня легкая форма NIH-синдрома.
Включение исходных данных в отчёт
Это совсем тупая мини-задача, но её решение я тоже опишу.
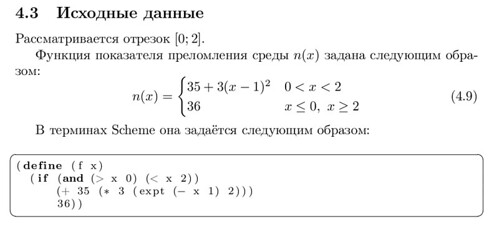
В проекте исходные данные хранятся в отдельных текстовых файлах и содержат определение одной-единственной функции, необходимой для расчёта, а также несколько определений числовых параметров. Определение функции на Scheme также предварено TeX-комментарием (о которых я писал выше), который также предполагается вставлять в документ. Выглядит такой файл примерно так:
;;@ $n(x) = \begin{cases} 35+3(x-1)^2 & 0<x<2\ 36 & x \leq 0,\ x \geq 2 \end{cases}$ (define (f x) (if (and (> x 0) (< x 2)) (+ 35 (* 3 (expt (- x 1) 2))) 36))
(define right-bound 2) (define subintervals 100) (define test-epsilon 0.0001)
Вставка нужного текста в документ происходит по команде
\input{statement.scm-initial-data}. Получается что-то вроде:
[ ][]
Созданию требуемого файла отвечает следующее правило Makefile:
%-initial-data.tex: ${SOURCEDIR}/% initial-data.sh initial-data.tpl.tex $(SHELL) initial-data.sh $< > $@
Видно, что маленький [скрипт][] initial-data.sh всего лишь
натравливается на файл с исходными данными. При помощи cat(1),
grep(1), sed(1) он втупую извлекает две цифирьки и размеченное
TeX-ом определение функции. Его работа завершается вызовом m4(1) на
очередной шаблон:
Рассматривается отрезок $[0; __RIGHTBOUND]$.
Функция показателя преломления среды $n(x)$ задана следующим образом: \begin{equation}\label{__LABEL} __NTEX \end{equation}
И вновь при помощи \label{__LABEL} генерируется метка вида
file.scm-initial-data, на которую я потому могу сослаться.
Включение результатов расчёта в текст работы
Тут снова пригодился бы Lisp2TeX, но непонятно, как он обработает код с явными Guile-измами (я использовал для реализации [Guile][]) и помимо включаемых напрямую в TeX-документ двух несчастных коэффициентиков мне требовалось включить в него же созданный промежуточным преобразованием график, отрисованный Metapost.
Расчёты тривиальные и нересурсоёмкие, поэтому лучшее решение — самое
простое: выводить результаты (построенное решение и информацию о нём) на
стандартный вывод в формате, удобном для обработки обычными средствами
текстового преобразования (grep(1), tail(1), sed(1)), разрезать
этот вывод на удобные кусочки, которые впоследствии передаются в
каком-то виде на дальнейшую обработку:
-
приближённое решение в виде трёх столбцов вида
x Re(u(x)) Im(u(x)) -
два искомых по условию задачи числа
AиB -
некоторые дополнительные данные, также обрабатываемые и включаемые в отчёт
Приближённое решение передаётся в Metapost для создания графика, который включается в документ, а найденные коэффициенты включаются в документ сразу.
Как говорит расчётная программа
Сначала идут три столбика (аргумент, действительная часть значения,
мнимая часть значения) из пары сотен строк. Они скучные, поэтом я
привожу лишь последние строки вывода расчётной программы. Блоки
разделяются [классическим][] %%.
1.9452736318408 0.642259739680568 -0.761159271604867 1.95522388059701 0.687848180515163 -0.721539051510589 1.96517412935323 0.730907823000578 -0.679195358916038 1.97512437810945 0.771268488932788 -0.634284101266255 1.98507462686567 0.808769344860717 -0.586971358440383 1.99502487562189 0.843259561005711 -0.537432806000248 %% A: -0.00478-0.00750i B: 0.99996-0.00104i conserves: yes
eps: 0.0001 method: fundmatrix time: 2.987552
Текстовый обмен данными прозрачен и прост. Используйте простой текст!
«Где же вы, числа?»
Я пишу в своём документе:
\input{fundmatrix__statement.scm-results}
Это означает: вставить результаты расчёта методом fundmatrix с
исходными данными statement.scm. Это позволяет без лишних движений
вставлять в документ результаты расчётов с разными исходными данными и
разными методами.
В итоге вставляется текст такого вида (я скопировал этот отрывок из финальной PDF-ки):
В результате использования метода были получены следующие результаты: A = −0.00478 − 0.00750i (4.10) B = 0.99996 − 0.00104i Подтверждено, что значения A и B удовлетворяют условию 2.1: 2 2 |A| + |B| − 1 < 0.0001 Расчёт занял 2.987552 с.
В Makefile на эту тему представляют интерес два правила:
%-results: ${SOURCEDIR}/$$(call get-target-source,$$)
${SOURCEDIR}/$$(call get-target-method,$$)-solution.scm
${SHARED_SOURCES} results.sh
$(SHELL) results.sh $< $(call get-target-method,$*) dispatcher.scm ${SOURCEDIR} > $@
%-results.tex: %-results %-plot.mps texify-results.sh results.tpl.tex $(SHELL) texify-results.sh $< > $@
Из этих двух первая цель описывает зависимость второй. Первая цель
довольно скучная, достаточно сказать лишь о том, что она запихивает в
файл с именем вида method_statement.scm-results результаты работы
расчётной программы (пример этих результатов приводился выше) с методом
method и исходными данными statement.scm. А вторая цель, как видно,
уже на этот файл натравливает пока неизвестный скрипт
texify-results.sh, который гламурно оформляет результаты расчёта.
Принцип его работы уже знаком: извлечь нужные данные, при помощи m4(1)
подставить их в [шаблон][] results.tpl.tex, который состоит из
следующих букв:
define(__CONSERVE_yes', Подтверждено')
define(__CONSERVE_no', Не подтверждено')
В результате использования метода были получены следующие результаты: \begin{equation}\label{__LABEL} \begin{aligned} &A=__A \ &B=__B \end{aligned} \end{equation}
\emph{__CONSERVE_STATUS}, что значения $A$ и $B$ удовлетворяют условию \ref{energy}:
\begin{displaymath} \abs{\left( \abs{A}^2 + \abs{B}^2 \right) - 1} < __EPS \end{displaymath}
Расчёт занял __TIME с.
Сам скрипт [texify-results.sh][] определяет макросы __A, __B,
__TIME, __EPS, значения которых извлекаются из вывода расчётной
программы (строки на A:, B:, time:, eps: соответственно). Их
семантика очевидна. Макрос __LABEL заменяется на выражение вида
method__statement.scm-results, так что потом в документе я могу
сослаться на конкретно эти результаты при помощи \eqref или
\pageref.
Любопытен метод подстановки словосочетания «Подтверждено»/«Не
подтверждено» в зависимости от результатов расчёта (строчка
conserves: yes): __CONSERVE_STATUS раскрывается в один из двух
других макросов __CONSERVE_yes или __CONSERVE_no, которые уже
содержат желанные слова на русском языке. Это сделано для того, чтобы
вся информация об оформлении полностью содержалась в шаблонной части.
Графики решений с MetaPost
[Metapost][] является замечательным средством для подготовки различной
графики для LaTeX и вообще основанных на TeX решениях (впрочем, может
использоваться и отдельно). Макропакет mpgraph для Metapost позволяет
без труда выводить несложные графики по заданному набору точек.
Семантика включения графика решения немного отличается от уже отработанной схемы «texdepend — make — скрипты».
В исходнике отчёта о курсовой работе задана удобная команда
\includeplot:
\newcommand{\includeplot}[2]{\begin{figure}[hb] \centering \includegraphics{#1__#2-plot.mps} \caption{График $u(x)$ для функции преломления \eqref{#2-initial-data}} \end{figure}}
Это сделано исключительно во избежание дублирования одинаковых
конструкций в исходнике. Кстати, в подпись в картинке внедряется ссылка
на ранее включённые в документ исходные данные, которым соответствует
график: \eqref{#2-initial-data}.
Включение графика решения, построенного при помощи метода, скажем
fundmatrix с исходными данными из statement.scm, осуществляется так:
\includeplot{fundmatrix}{statement.scm}
Обычный texdepend(1) уже не может отследить такую зависимость. Можно,
однако, поступить так: график логично включать в курсач после численных
результатов расчёта. Как раз при включении этих численных результатов
можно генерировать и график (указав его в качестве зависимости цели
%-results.tex). Тогда конструкция с \includeplot успешно найдёт
картинку в файлике с именем вида method__statement.scm-plot.mps. Итак,
правила для его генерации таковы:
%-results.tex: %-results %-plot.mps texify-results.sh results.tpl.tex $(SHELL) texify-results.sh $< > $@
%-plot.mps: %-results plot-results.sh plot.tpl.mp $(SHELL) plot-results.sh $<
Видно, что plot-results.sh — [сценарий][], обрабатывающий всё тот же
текстовый вывод работы расчётной программы. Однако, в то время как
texify-results.sh интересовался разными данными после разделителя
%%, plot-results.sh концентрируется на куче чисел до него. Принцип
же работы этого скрипта уже знаком: он всего-навсего заставляет m4(1)
подготовить результаты расчётной программы к вычерчиванию (а именно,
отрезать всё после %% :-) и выполнить несколько макроподстановок в
[Metapost-шаблоне][], которые я перечислю далее.
Во-первых, нужно заставить Metapost давать выходному файлу желаемое имя
изменением переменной filenametemplate:
filenametemplate "__PLOT_PREFIX.mps";
Макрос __PLOT_PREFIX определяется в управляющем сценарии
plot-results.sh и заменяется на требуемую по условию строку вида
method_file.scm-plot, так что mpost(1) на выходе даст картинку с
нормальным именем, которую впоследствии увидит \includeplot в моём
LaTeX-исходнике.
На самом деле, шаблон plot.tpl.mp заточен под вывод графиков
произвольного количества функций в одной области. Мне это также
потребовалось для курсовой — в конце нужно сопоставить результаты
вычислений разными методами.
Далее, cобственно вычерчиванием графиков занимается следующий Metapost-код:
for file = __DATA: color real_color, imag_color; path real_plot, imag_plot;
real_color = blue*(0.5+uniformdeviate(5)/10)+greenuniformdeviate(2)/10+whiteuniformdeviate(15)/100; imag_color = red*(0.5+uniformdeviate(5)/10)+white*uniformdeviate(15)/100;
gdata(file, f, augment.real_plot(f1, f2); augment.imag_plot(f1, f3););
gdraw real_plot withpen __PEN withcolor real_color; __LABEL(glabel.ulft(btex $\Re$ etex, 1) withcolor real_color*0.8;)
gdraw imag_plot withpen __PEN withcolor imag_color; __LABEL(glabel.llft(btex $\Im$ etex, 1) withcolor imag_color*0.8;)
endfor;
В глаза здесь сразу бросаются другие три макроса:
-
__DATA, который заменяется на список файлов с описанием данных для вычерчивания (или, в рассматриваемом случае, одно-единственное имя файла с уже знакомыми столбцамиx Re(u(x)) Im(u(x))). -
__PENопределяется в зависимости от количества вычерчиваемых наборов точек (когда строится один график, линия жирная, когда много — тоньше). Применяется такой же подход, как в случае с макросом__CONSERVE_STATUSв шаблоне для вывода численных результатов счёта:__PENраскрывается в один из двух других макросов__PEN_singleили__PEN_multi, которые определены уже в самом шаблоне для разделения работы по подготовке данных и непосредственному оформлению графика:define(
__PEN_single',pencircle scaled 1.5') define(__PEN_multi',pencircle scaled 0.8') -
__LABEL, по аналогии с__PEN, определяется как нулевой (раскрывающийся в пустоту) макрос, если я вывожу несколько графиков, и как тождественный (раскрывающийся в свой аргумент без изменений), если я вывожу график одного решения.
Конструкция
gdata(file, f, augment.real_plot(f1, f2); augment.imag_plot(f1, f3););
построчно читает из файла строки, записывая элементы первого и второго
столбца как (x, y) в первую кривую, а элементы первого и третьего — во
вторую кривую. Получаются две кривые, соответствующие действительной и
мнимой части вычерчиваемого решения. После этого две команды gdraw
выводят собранные кривые в область построения.
Адаптируйте!
Я использовал LaTeX, Scheme, Metapost, однако описанные подходы применимы и к совершенно другим комбинациям средств:
-
я мог бы автоматизировать генерацию документа на любом другом языке, будь то XHTML или Texinfo (для них было бы нетрудно написать свои аналоги Texdepend)
-
я мог бы вставлять в свой документ гораздо более сложные результаты расчётов, полученные не простой программой на Scheme, а при помощи мощных средств численного анализа вроде [Octave][]
-
я мог бы и использовать другое средство построения графиков: [gnuplot][], [ePiX][], [pgf][], [PyXPlot][]. Главное, чтобы поддерживался простой текстовый командный интерфейс
Уроки простоты
Всё описанное очень просто в реализации благодаря использованию прозрачных и открытых форматов данных. LaTeX — это простой текст. Описания картинок MetaPost — простой текст. С простым текстом легко работать, его легко создавать простыми средствами и изменять при помощи, скажем, m4. Посчитал — разрезал вывод, отфильтровал нужное — подставил в шаблон — заинклудил в документ. А текстовый доступный Makefile позволяет быстро понять структуру процесса сборки документа.
Однако, говоря «простой», я не подразумеваю «лёгкий» :-)
Наверное, как-то так: UNIX — это просто, но не легко!
[]: http://www.flickr.com/photos/nothingpersonal/2068111487/
"screen1196171299 by Dmitry Dzhus, on Flickr"
[скрипт]: http://github.com/dzhus/term-paper-diffeq/blob/4319de9/doc/initial-data.sh
[Guile]: http://www.gnu.org/software/guile/
"GNU Guile — реализация языка Scheme"
[классическим]: http://www.catb.org/~esr/writings/taoup/html/ch05s02.html#id2906931
"The Art Of Unix Programming: Record-Jar"
[шаблон]: http://github.com/dzhus/term-paper-diffeq/blob/4319de9/doc/results.tpl.tex
[texify-results.sh]: http://github.com/dzhus/term-paper-diffeq/blob/4319de9/doc/texify-results.sh
[Metapost]: http://ru.wikipedia.org/wiki/MetaPost
[сценарий]: http://github.com/dzhus/term-paper-diffeq/blob/4319de9/doc/plot-results.sh
[Metapost-шаблоне]: http://github.com/dzhus/term-paper-diffeq/blob/4319de9/doc/plot.tpl.mp
[Octave]: http://www.gnu.org/software/octave/
[gnuplot]: http://www.gnuplot.info/
[ePiX]: http://mathcs.holycross.edu/~ahwang/current/ePiX.html
[pgf]: http://www.ctan.org/tex-archive/help/Catalogue/entries/pgf.html
[PyXPlot]: http://www.pyxplot.org.uk/